

Il modello Jev non scrive niente, e non è un modo di dire: non risponde a domande, non produce testi, non genera codice. Riceve una richiesta scritta in linguaggio normale e restituisce una decisione — una categoria, un punteggio, o quanto è sicuro di una risposta — in un tempo dichiarato tra 70 e 500 millisecondi. A costruirlo è TypeSafe AI, startup uscita dalla modalità silenziosa il 15 settembre 2026. Due anni di lavoro lontano dai riflettori e 40 milioni di dollari raccolti dagli investitori, con DCVC in testa. Il nome dietro il progetto è quello di Diogo Almeida, ex OpenAI e Google Brain, tra gli autori della ricerca sull’apprendimento con feedback umano da cui è nata ChatGPT.
La notizia non sta nella velocità. Sta nel problema che il modello Jev di TypeSafe AI sceglie di affrontare. Non è una questione di conversazione: è una questione di affidabilità dentro il software. Almeida lo ha detto senza giri di parole: il suo modello è «più simile a un database che a un collega di lavoro». Dodici giorni prima del lancio, sul suo profilo, aveva spiegato il senso dell’operazione con una frase che vale più di qualunque grafico: «Addestrando i modelli a servire gli esseri umani, finiscono per preferire risposte verosimili piuttosto che deluderti» (traduzione redazionale). Ottimizzare per il gradimento umano, sostiene, ha un costo preciso in affidabilità. Ed è il costo che la sua azienda prova a non pagare.
Indice
Che cosa fa Jev, in concreto
Un modello linguistico normale, messo dentro un’automazione, produce testo e poi si fa interpretare dal codice. È un passaggio fragile, lento e costoso: si paga per token che nessuno leggerà mai. Jev salta il passaggio. Non scrive frasi: sceglie da una lista di opzioni già stabilite — una categoria, un punteggio, un sì o un no. E insieme alla scelta consegna un numero, che dice quanto è sicuro di quella risposta. Il codice può usare quel numero per decidere se fidarsi da solo o passare la pratica a una persona.
Tradotto in casi reali, significa piazzare dei giudizi istantanei dentro i flussi di lavoro:
- smistare una richiesta di assistenza tra pagamenti, spedizioni e resi prima che un operatore la apra;
- decidere se una conversazione commerciale è pronta per un preventivo o va tenuta in attesa;
- classificare record, ticket e segnalazioni in grandi volumi senza passare da un modello completo;
- controllare il testo prodotto da un’altra IA prima che diventi un’azione, per esempio verificando che non prometta qualcosa che non esiste a listino;
- segnalare quando serve un essere umano, invece di decidere da solo.
«I grandi modelli linguistici sono progettati per produrre testo destinato alla lettura umana. Quando un modello deve esprimere un giudizio che userà il tuo codice, si crea un disallineamento» (traduzione redazionale), si legge nella documentazione di TypeSafe AI.
In parole povere: i modelli normali sono addestrati a parlare con le persone, non a dare risposte che un programma possa usare così come sono.
Il tema degli agenti che lavorano dentro il software non è nuovo. OpenAI Codex, l’agente AI per sviluppatori, lo ha portato sui Mac all’inizio dell’anno, ma lì il modello scriveva ancora codice, cioè testo da interpretare. Qui il principio è lo stesso che i modelli generalisti usano quando restituiscono risposte già formattate per il codice, portato alle estreme conseguenze. Non è una tecnologia nuova di zecca: è una specializzazione spinta. La scommessa di TypeSafe è che specializzarsi convenga, invece di usare un modello enorme per una scelta tra cinque opzioni. Il mercato dovrà dire se ha ragione.
I numeri dichiarati, e cosa manca per crederci
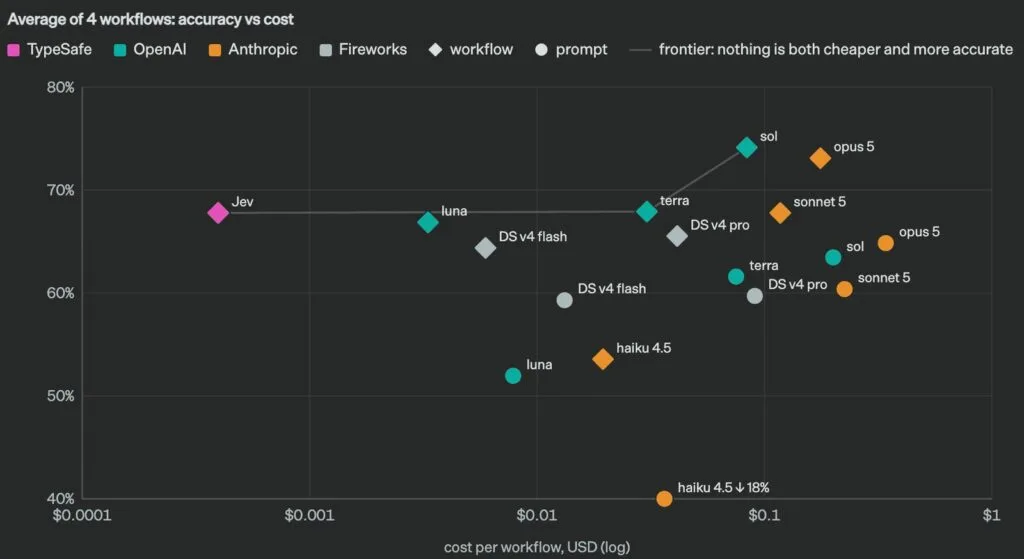
I numeri del lancio sono aggressivi. Vanno letti per quello che sono: dichiarazioni dell’azienda, non misure indipendenti.
- 0,042 dollari per milione di token in ingresso — un token è all’incirca una parola — con l’uscita non fatturata, perché l’uscita non è testo;
- 20-200 volte più veloce e 40-400 volte più economico: due intervalli che l’azienda calcola sui propri confronti interni, non sul listino dei singoli modelli;
- tempi di risposta da 70 a 500 millisecondi, contro i 3-329 secondi dei modelli di frontiera;
- un metodo di addestramento proprietario, che l’azienda chiama RLCD: il modello viene corretto tante volte da far coincidere la sua sicurezza con quanto ci azzecca davvero.
Il confronto, però, ha due buchi. Il primo: nella tabella non c’è GPT-6 Astra, il modello più recente di OpenAI — e senza quello il paragone resta incompleto. Il secondo: Jev non lo può ancora provare nessuno, si entra solo su richiesta. Sul prezzo c’è un’ammissione che vale più di un grafico: l’azienda non esclude che quei 0,042 dollari siano, per ora, in parte pagati da lei. È più onesto di chi giura che i conti tornino. Anche i guadagni raccontati da chi l’ha provato in anteprima sono veri, ma più piccoli del previsto: decine di volte più veloce su casi precisi, non centinaia di volte su tutto. La sintesi più utile l’ha scritta The Decoder: rispondere in modo ordinato non basta a distinguersi. Per vincere, Jev dovrà essere non solo più rapido ed economico, ma abbastanza accurato.
Il punto vero: non serve un’IA che parli, serve una che decida
Il limite dell’automazione nelle aziende non è mai stato la capacità di scrivere una frase convincente. È la capacità di decidere in modo ripetibile, a costi trascurabili, migliaia di volte al giorno. Quando quel costo crolla, il punto critico non è più quanto è potente il modello, ma quanto è affidabile la sua decisione.
Ed è qui che il claim più fragile merita una precisazione. «Non allucina mai» — ripetuto da Hardware Upgrade e da altre testate — significa una cosa sola: Jev non può inventare una risposta fuori dalle opzioni che gli sono state date, perché si muove dentro una lista chiusa. Non significa che non possa sbagliare scelta. In un’automazione, l’errore non si presenta come una frase assurda. Si presenta come una pratica instradata al reparto sbagliato, una priorità mal assegnata, un blocco applicato alla persona sbagliata. È un errore silenzioso, molto più difficile da notare di un testo sbagliato.
C’è poi la conseguenza economica di un prezzo quasi nullo. Se un giudizio costa una frazione di centesimo, la tentazione è metterlo ovunque. Più automazione significa più valore prodotto, ma anche più superficie su cui un modello che sbaglia troppo spesso può fare danni. Il confronto con il lancio delle app per ChatGPT aiuta a misurare la distanza: quelle erano interfacce pensate per conversare con una persona, questo è un mattone per chi costruisce automazioni. La domanda che le aziende si troveranno davanti non sarà «funziona?», ma «quanto sbaglia, e come me ne accorgo?».
Chi è Diogo Almeida, in due righe
Ex OpenAI e Google Brain, co-fondatore e amministratore delegato di TypeSafe AI. Il suo nome compare tra gli autori di InstructGPT (2022), il paper che ha descritto l’addestramento con feedback umano alla base di ChatGPT, e tra i firmatari del rapporto tecnico di GPT-4. La formula «co-inventore di ChatGPT», usata in molta stampa, è una semplificazione: sul sito della sua azienda la versione corretta è «co-invented RLHF and InstructGPT». Con lui, nella startup, ci sono Erik Gafni e Sasha Sheng.
Le domande più comuni
Che cos’è Jev di TypeSafe AI?
È il primo modello, secondo l’azienda, di una famiglia che TypeSafe chiama System One Models. Riceve testo scritto da una persona e restituisce una scelta già pronta per il codice — una categoria, un punteggio, un sì o un no — con accanto quanto è sicuro di averci azzeccato.
Jev sostituisce ChatGPT?
No, e lo dice l’azienda stessa. Jev non scrive, non conversa, non produce codice. Non è un assistente: è un componente da incastrare dentro un software. La concorrenza è con le chiamate ai modelli generalisti usate per compiti di classificazione, non con un chatbot.
Quanto costa e quanto è veloce?
Secondo TypeSafe, 0,042 dollari per milione di token in ingresso, uscita non fatturata, e risposte tra 70 e 500 millisecondi. Sono dati dichiarati, non verificati in modo indipendente: l’azienda non ha fornito il modo di replicare i propri test.
Si può provare oggi?
Non per il pubblico. Il modello è in lista d’attesa per l’accesso anticipato, che si richiede dal sito di TypeSafe AI. Al momento, l’unica valutazione possibile riguarda l’architettura e i numeri dichiarati, non il comportamento reale del sistema su un compito di produzione.
La prova, quando arriverà, non sarà un grafico sul sito dell’azienda. Sarà mettere Jev dentro un flusso di lavoro vero, con le sue eccezioni, e contare quante volte sbaglia decisione. E quante volte nessuno se ne accorge.